Eu costumava olhar para multiagentes com uma certa desconfiança. Mais agentes pareciam significar mais chamadas, mais custo e mais chance de alguém se perder no caminho.
Ainda pode acontecer. Mas os modelos menores ficaram tão mais rápidos, baratos e capazes que acho que vale olhar de novo. Se um modelo que custa cerca de vinte vezes menos por token que o modelo maior consegue fazer bem uma parte específica do trabalho, por que não dar essa parte para ele?
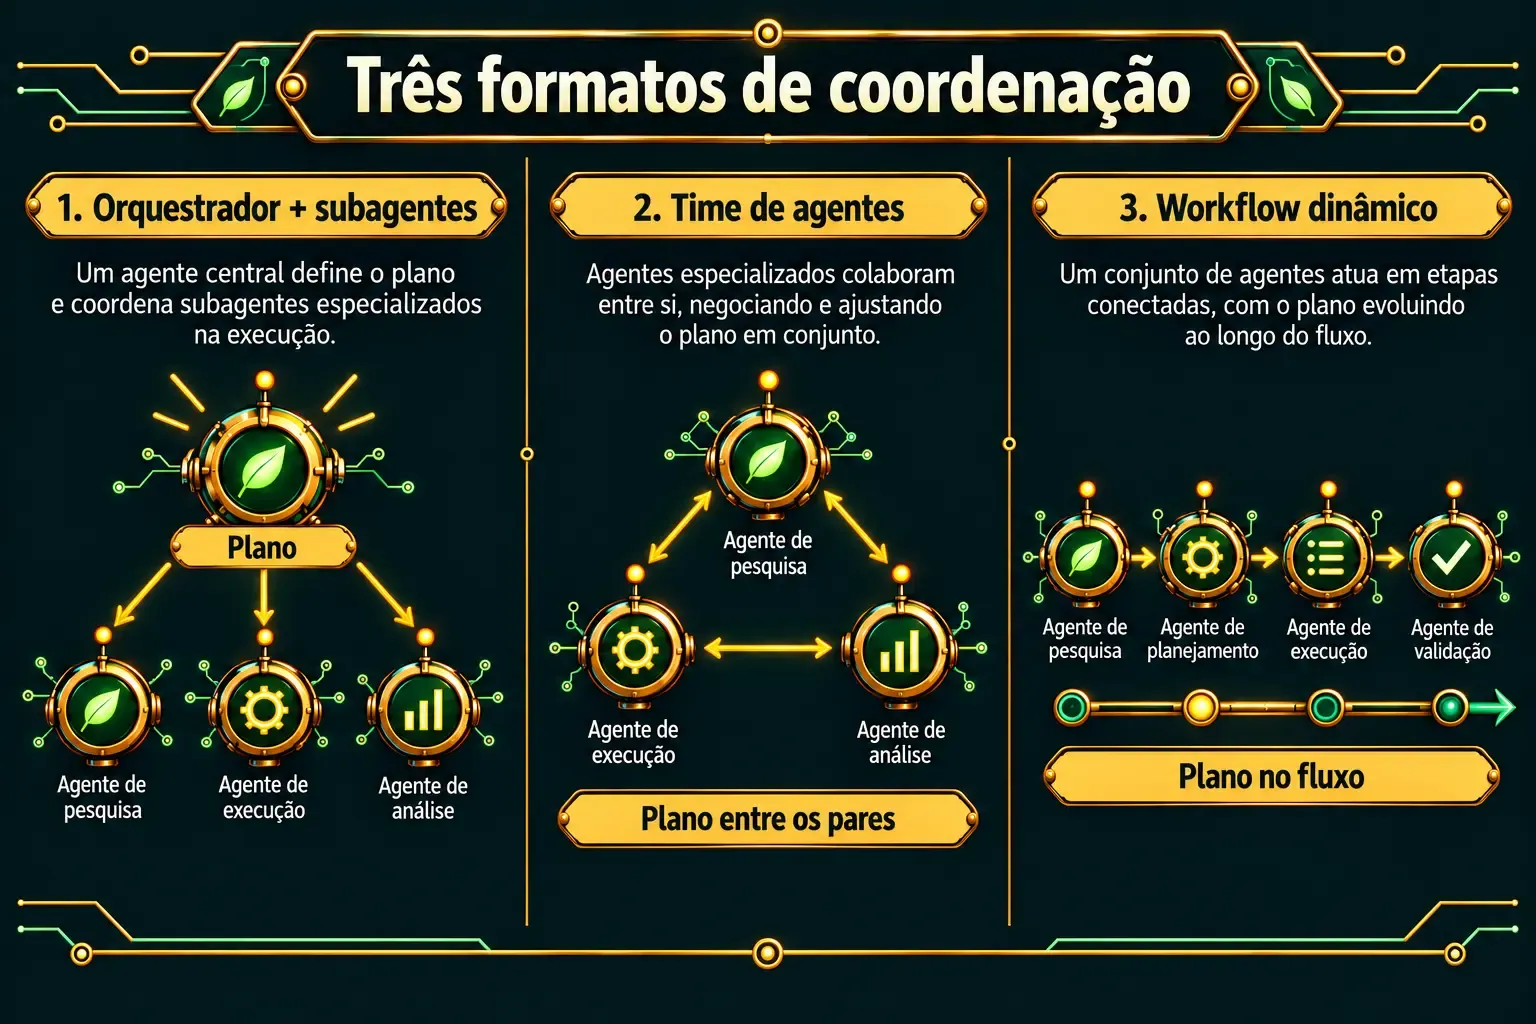
Antes de entrar nos exemplos, tem três ideias que ajudam a não misturar tudo:
- Orquestrador + subagentes: um agente principal divide o trabalho, recebe as respostas e junta tudo no final.
- Time de agentes: vários agentes podem conversar e se ajustar entre si enquanto trabalham.
- Workflow dinâmico: o plano fica num fluxo de execução; ele decide quem chamar e qual é o próximo passo conforme a tarefa avança.
Eles podem se misturar. Um orquestrador, por exemplo, pode chamar vários agentes em paralelo e mandar o resultado para revisão.
Daqui em diante, quando eu falar em sistema multiagente, estou falando de um destes três formatos: orquestrador + subagentes, time de agentes ou workflow dinâmico.
Por que usar mais de um agente?
O principal motivo é simples: hoje dá para deixar o modelo mais caro com o trabalho que realmente precisa dele e passar tarefas menores para modelos mais baratos.
- Modelos pequenos deixaram de servir só para classificação simples. Eles já conseguem pesquisar, resumir, usar ferramentas, checar um critério e fazer partes menores de uma tarefa de programação.
- O Haiku 5.5 é um bom exemplo dessa evolução: a Anthropic o posiciona para trabalho de alto volume, subagentes e tarefas sensíveis à velocidade.
- Até 100 mil tokens por prompt, o preço de entrada e de saída do Haiku 5.5 é cerca de 20 vezes menor que o do Sonnet 5.5. Isso não quer dizer que ele resolve o mesmo tipo de problema, mas muda a conta quando a tarefa pode ser bem dividida.
Contexto maior também ajuda. O Haiku 5.5 tem janela anunciada de até um milhão de tokens. Mesmo assim, contexto grande não é desculpa para jogar tudo na conversa. Ainda importa escolher o que cada agente precisa saber e o que pode ficar fora.
Onde uso mais de um agente no meu dia a dia?
Eu acabei chegando a dois usos recorrentes.
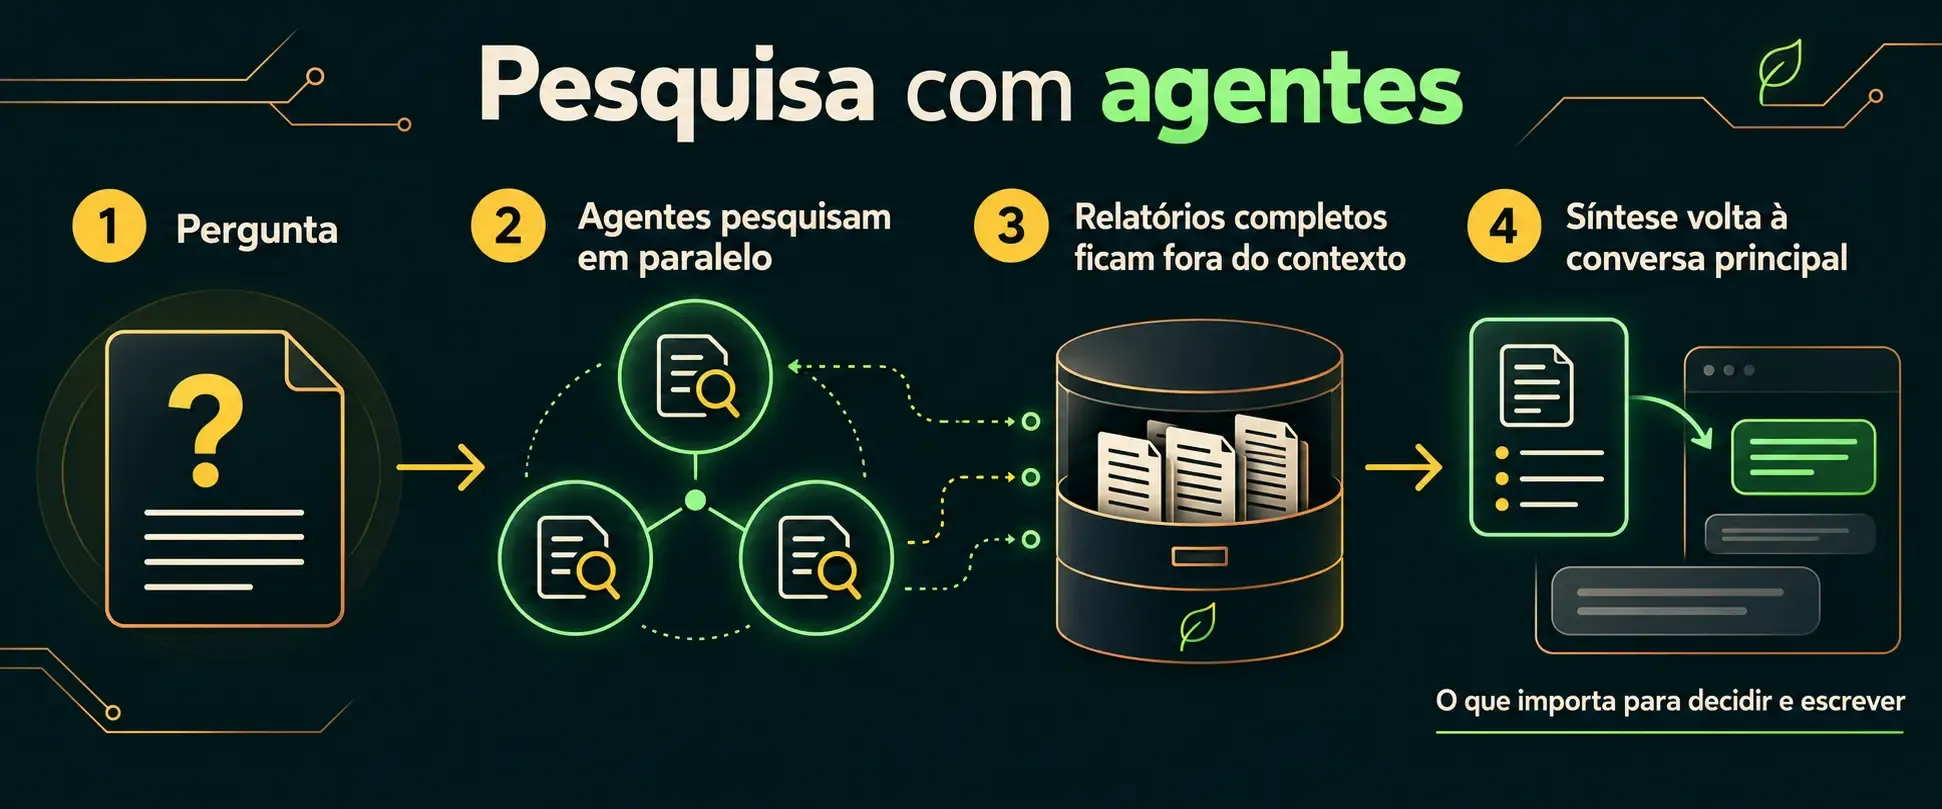
Para pesquisar. Em vez de colocar uma montanha de notas e fontes na conversa principal, eu delego partes da pesquisa e leio os relatórios completos depois. O material intermediário fica fora do contexto principal; o que volta para mim é o que importa para decidir e escrever. Isso deixa a conversa mais limpa sem jogar fora o trabalho feito.
Para programar. Eu separo execução e revisão. Um agente trabalha na tarefa; outro procura ponto cego, falha de lógica, conflito no código e coisas que passaram batido. Às vezes tento dar menos contexto para quem revisa, para ele não chegar já convencido pela solução original. Ainda quero entender melhor como esse “contexto cego” funciona no harness que uso. A ideia faz sentido, mas não quero vender como uma técnica comprovada antes de testar direito.
Também não trato validador como verdade absoluta. Estudos mostram que um modelo nem sempre encontra o próprio erro quando é chamado para se revisar, e avaliadores também podem ter vieses. Para mim, a revisão automatizada é mais uma camada para garantir que a tarefa foi executada do início ao fim. A revisão final continua sendo humana.
Qual foi o melhor caso de uso?
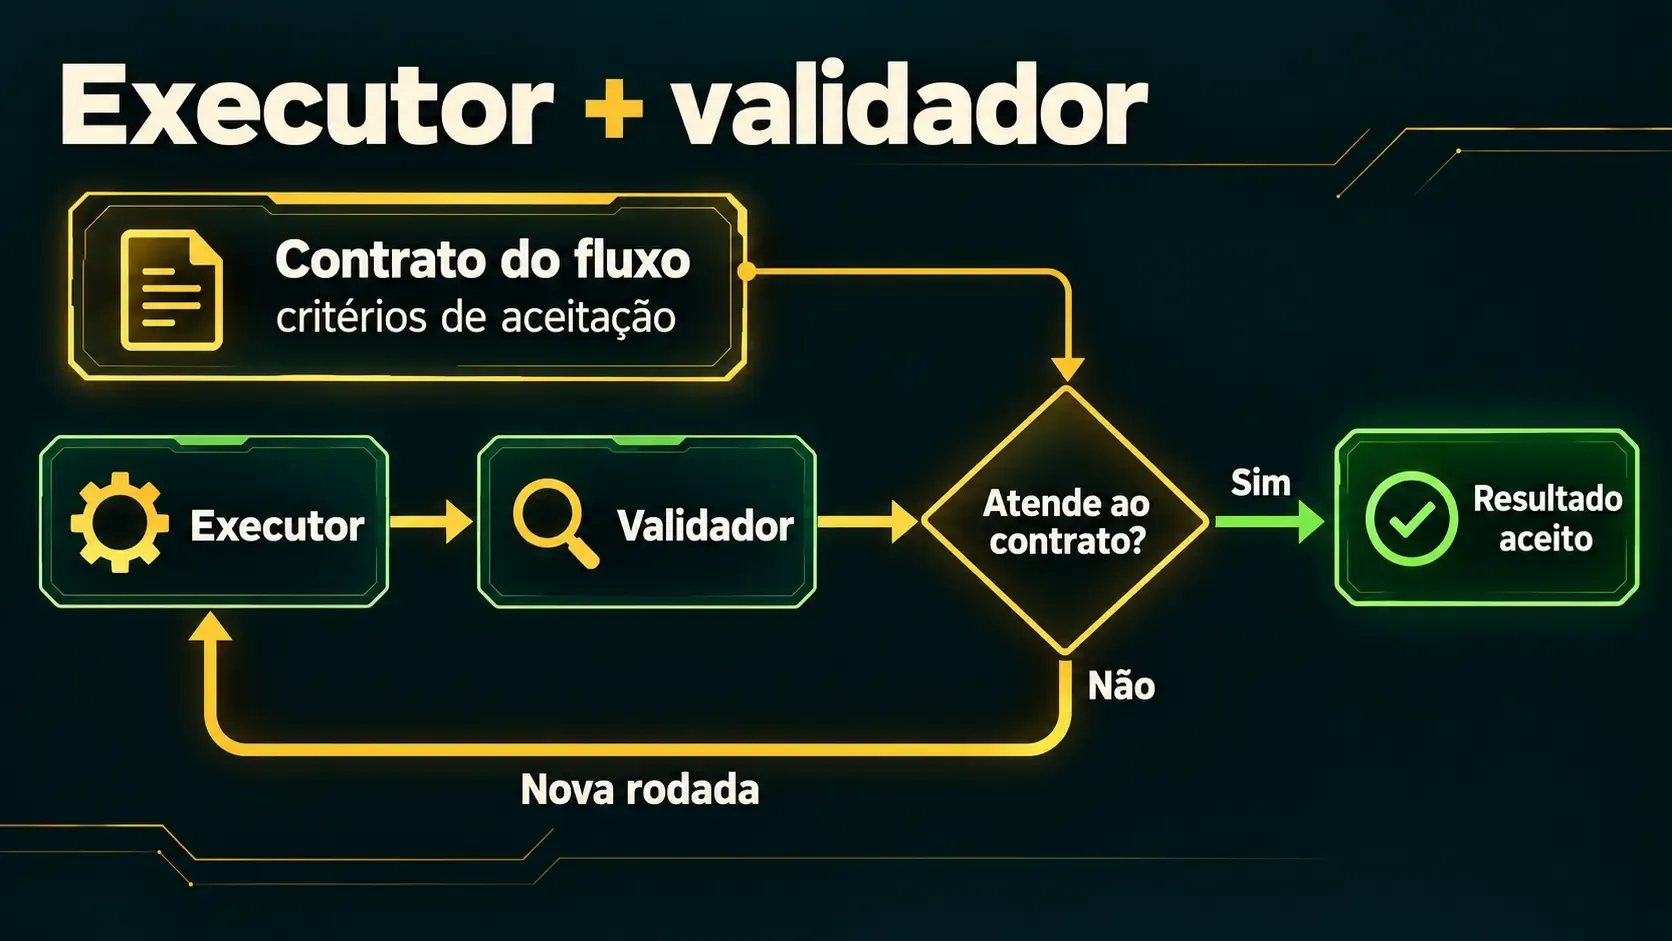
O padrão que mais tem me chamado atenção é executor + validador com Haiku. Um agente faz a tarefa e outro confere se ela atende aos critérios combinados. Se a revisão encontra um problema, o ciclo volta para correção. Só para quando chega no que foi definido como aceito.
O motivo não é usar dois agentes por usar. É poder gastar pouco em tarefas menores e repetir a revisão quando ela fizer sentido. Para mim, isso é especialmente útil em código: um agente pode implementar e o outro pode procurar inconsistência, quebra de regra ou efeito colateral.
Um teste de auditoria de código publicado em “A Harness for Every Task” comparou um agente trabalhando sozinho com um workflow no mesmo repositório. O agente solo encontrou 47 problemas e usou cerca de um terço dos tokens do workflow, que encontrou 44 candidatos; a verificação do workflow confirmou 40 e retirou dois achados incorretos que também apareciam na rodada solo. A cobertura bruta foi parecida, mas o fluxo de verificação acrescentou uma checagem de qualidade ao custo de aproximadamente três vezes mais tokens. É um bom lembrete: a divisão só compensa quando o ganho de confiança vale o custo extra — uma conta que fica mais interessante à medida que modelos menores conseguem assumir partes bem delimitadas do trabalho.
Quanto isso custa na prática?
Para ter uma noção da ordem de grandeza, dá para comparar volumes totais de tokens distribuídos entre as chamadas de um workflow. A tabela abaixo supõe que 80% sejam tokens de entrada e 20% de saída, com os preços públicos para prompts de até 100 mil tokens. É uma simulação de preço por token, não uma previsão de fatura: cache, chamadas com contexto maior, ferramentas e a quantidade de tentativas podem mudar o total.
As linhas de código e os tamanhos de repositório abaixo são referências de escopo, não uma conversão fixa de tokens em produtividade. O consumo real varia com a linguagem, os arquivos que cada agente precisa ler, o histórico repetido nas chamadas e quantas rodadas de correção e validação forem necessárias.
Volume total de tokens (80% entrada, 20% saída) | Exemplo de uso | Haiku 5.5 | Sonnet 5.5 |
1 milhão | MVP de uma API de tarefas, em um repositório de até ~5 mil linhas: cadastro, login, 5–7 endpoints CRUD, banco SQLite ou PostgreSQL, validação de entrada e testes básicos. Escopo ilustrativo: ~800–1.500 linhas novas ou alteradas. | US$ 0,18 | US$ 3,60 |
5 milhões | Funcionalidade de cobrança em um produto com ~20–50 mil linhas: checkout, webhooks idempotentes, migração de banco, integração com a interface, testes de falha e documentação. Escopo ilustrativo: ~2–5 mil linhas alteradas, com implementação e revisão separadas. | US$ 0,90 | US$ 18,00 |
10 milhões | Mudança transversal em um sistema com ~50–150 mil linhas: adicionar organizações e permissões por papel (RBAC) na API, no banco e nos jobs em segundo plano; incluir migração, testes de regressão e revisão de segurança. Escopo ilustrativo: ~5–10 mil linhas alteradas em vários módulos. | US$ 1,80 | US$ 36,00 |
Os valores ajudam a dimensionar o custo de experimentar: com modelos pequenos capazes de pesquisar, usar ferramentas, resumir e resolver etapas específicas de programação, alguns milhões de tokens podem ser suficientes para testar uma divisão real de trabalho por poucos dólares. Isso não prova que o modelo menor iguale o maior, nem que um workflow seja sempre mais barato no total. A decisão continua dependendo do que a tarefa entrega, da qualidade da validação e do retrabalho que ela evita. (Preços de Haiku 5.5 e Sonnet 5.5; dados do experimento.)
Como usar mais de um agente?
Na Anthropic, é possível combinar subagentes e equipes no Claude Code ou construir fluxos próprios com a Claude API. Na OpenAI, o Agents SDK permite manter um agente gerente que chama especialistas como ferramentas ou transferir o controle para um agente especialista. Em ambos os casos, o ponto de partida é definir responsabilidades, contexto e critérios de conclusão; a coordenação vem depois.
A Anthropic apresenta diferentes padrões de coordenação. A seguir, aprofundo quatro que ajudam a escolher como dividir e revisar o trabalho em aplicações práticas.
Padrões de uso
- Gerador + validador: um agente produz a primeira versão e outro a confere com critérios explícitos. Em código, o gerador implementa uma funcionalidade; o validador verifica os requisitos, executa ou propõe testes e aponta falhas concretas. Se algo falha, o trabalho volta ao gerador para correção. Funciona melhor quando é possível definir o que significa “passou”.
- Orquestrador + subagentes: um agente principal transforma a tarefa em partes delimitadas, delega cada parte e integra os resultados. Por exemplo, numa migração de uma API, subagentes podem cuidar separadamente do esquema do banco, dos endpoints e dos testes; o orquestrador resolve dependências e confere a integração. É adequado quando as partes são independentes o bastante para avançar em paralelo.
- Time de agentes: vários agentes continuam trabalhando numa tarefa longa e compartilham atualizações. Pense numa reforma: uma pessoa cuida da parte elétrica, outra da hidráulica e outra do acabamento. Cada uma acompanha sua frente, mas combina limites com as outras para evitar conflito e retrabalho. Em software, cada agente pode assumir um serviço ou módulo, implementar mudanças e rodar seus testes. Esse formato funciona melhor quando as responsabilidades estão bem separadas.
- Estado compartilhado: os agentes leem e atualizam uma base comum, como um quadro de tarefas, um documento de descobertas ou uma estrutura de dados. Em uma investigação de incidentes, um agente registra evidências de logs, outro relaciona os eventos ao código e um terceiro atualiza hipóteses e pendências. Esse formato é útil quando as descobertas de uma frente mudam o trabalho das outras; também exige controle de duplicidade, conflitos de escrita e critérios claros para encerrar.
Minha experiência e opinião
Eu usaria mais de um agente quando a tarefa é grande o bastante para ser dividida, quando várias partes podem acontecer em paralelo ou quando errar custa caro e vale pagar por uma segunda checagem.
Eu evitaria quando a tarefa é pequena, quando cada passo depende muito do anterior ou quando não existe um critério claro para a revisão. Nesses casos, criar um time pode ser só colocar cerimônia em cima de um trabalho que uma conversa resolve.
Em projetos mais complexos, tenho usado GSD dentro do Claude Code. Ali faz sentido colocar mais estrutura: há subagentes para pesquisa e planejamento, execução e verificação; arquivos Markdown guardam o estado do projeto; e existem gates para não sair pulando etapas. Se algo foge do combinado, o fluxo pede correção ou me chama para decidir. Também posso forçar confirmações antes de sair do plano ou mudar de contexto.
Esse tipo de fluxo traz fricção de propósito. Há mais paradas e confirmações, então ele não é o mais rápido. Em troca, eu acompanho melhor progresso, qualidade e aqueles desvios em que o projeto começa a ir para outro lugar sem ninguém perceber. Para um projeto complexo, principalmente quando a pessoa não é tão familiarizada com desenvolvimento, acho que isso vale bastante.
Quando quero velocidade e espaço para experimentar, uso um workflow mais dinâmico com Haiku. Cada subagente recebe um contrato de agente: um template preenchido antes da chamada, como uma lista curta do que ele precisa entregar e respeitar. Antes de tudo, eu ainda faço um refinamento com Claude para decidir critérios, restrições, trade-offs e o que vai contar como aceito. E no fim, eu reviso.
Três agentes nunca é demais
Hoje, eu acho que vale, sim, usar três agentes quando a tarefa pede isso. Um pode executar, outro pode validar e um terceiro pode coordenar ou sintetizar. Com papéis claros, essa divisão pode deixar o processo mais confiável sem transformar tudo em uma operação enorme.
Com modelos menores evoluindo tão rápido, a conta mudou. Poucos meses podem separar um modelo pequeno que só servia para uma tarefa mecânica de outro que já consegue pesquisar, programar uma parte específica, validar uma saída e usar ferramentas. Se ele custa perto de vinte vezes menos por token que um modelo maior, testar uma divisão de trabalho deixa de ser extravagância e passa a ser uma hipótese bem razoável.
Nos meus testes, workflows dinâmicos com Haiku têm parecido mais rápidos e baratos. Isso é uma observação pessoal, não uma lei geral. Para saber se vale no seu caso, eu olharia para quatro coisas: custo, tempo, qualidade e retrabalho.
No fim, o número de agentes é só um detalhe. O que importa é se eles deixam a tarefa melhor, mais barata, mais rápida ou mais segura. Se deixam, três não são demais. Podem ser só o começo.
Referências
- A Harness for Every Task: Putting a Team of Claudes on One Job
- Multi-Agent Coordination Patterns
- Claude Haiku 5.5: visão geral
- Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet
- LLMs cannot find reasoning errors, but can correct them given the error location
- FairJudge: An Adaptive, Debiased, and Consistent LLM-as-a-Judge