A janela de contexto é parte fundamental do funcionamento dos modelos de inteligência artificial. E conseguir dominar esse aspecto do modelo é essencial para realizar tarefas longas e complexas. Além de ser um limite conhecido da capacidade, quase ilimitada, dessa tecnologia.
Neste artigo, eu explico o que é essa janela, o que entra nela, o que acontece quando ela enche, por que um espaço grande nem sempre significa uma resposta boa e como a engenharia de contexto trata a janela como seu principal objeto de trabalho.
O que é a janela de contexto quando o assunto é inteligência artificial
A janela de contexto é a quantidade máxima de texto, medida em tokens, que um modelo de IA consegue considerar de uma vez para gerar uma resposta. Nela entram as instruções, a conversa, os arquivos e a própria resposta que está sendo escrita.
Se você já conversou com o ChatGPT, o Claude ou o Gemini por muito tempo, provavelmente viu isso na prática: um detalhe dado lá no começo some, como se nunca tivesse existido. Vale começar pelo nome.
Em inglês, o termo é context window. Em português, "janela de contexto" é a tradução adotada na documentação da Anthropic em português e na documentação em português do Google. O termo é mais antigo que os chatbots: no processamento de linguagem natural clássico, em modelos como word2vec e GloVe, a janela de contexto era a faixa de 1 a 10 palavras vizinhas usada para entender uma palavra.
O sentido atual apareceu no artigo do GPT-3, da OpenAI, de 2020. Todos os modelos daquela geração tinham janela de 2.048 tokens, e esse número limitava quantos exemplos cabiam no prompt. De umas 10 palavras ao redor de cada termo, o nome passou a significar um livro inteiro.
A escalada foi rápida. O GPT-1 (2018) tinha 512 tokens, o GPT-2 (2019), 1.024, e o GPT-4, em março de 2023, chegou a 8.192 e 32.768. Em maio de 2023, a Anthropic lançou o Claude 100K, com 100 mil tokens, cerca de 75 mil palavras. Para mostrar o tamanho, a empresa fez o modelo ler O Grande Gatsby inteiro, cerca de 72 mil tokens, e ele respondeu em 22 segundos. Desde 2025, cerca de 1 milhão de tokens virou o padrão dos modelos de ponta.
A comparação que mais uso é com a memória RAM do computador. Andrej Karpathy popularizou a imagem de um novo sistema operacional, em que o modelo é o processador e a janela de contexto é a memória RAM. Ele tratou disso no vídeo Intro to Large Language Models, de novembro de 2023, e numa palestra na Y Combinator, em junho de 2025.
Em português, o glossário da Anthropic chama a janela de "memória de trabalho" do modelo, e a documentação do Google a compara com a memória de curto prazo.
Pense na sua mesa de trabalho. Tudo que está em cima dela você alcança com um olhar, e é rápido. Mas a mesa tem tamanho fixo. A janela é a mesa do modelo: é o que ele "vê" nesta resposta. O que está fora dela, ele não sabe. Gaveta fechada não existe para o modelo, a menos que alguém a traga para cima da mesa.
O modelo não guarda nada de uma mensagem para a outra. Ele é "sem estado", então a conversa inteira é reenviada a cada nova mensagem. Quando você sente que a IA "lembrou" de algo, ela na verdade leu tudo de novo. E há um motivo físico para o limite.
No Transformer, descrito em "Attention Is All You Need" (Vaswani et al., 2017), cada token presta atenção a todos os outros. Por isso o custo cresce de forma exponencial com o tamanho do texto, ou seja, dobrar o texto quadruplica o trabalho do computador. A memória da GPU que fica com esse trabalho, o chamado cache KV, também cresce junto.
A analogia também falha. A RAM não "esquece" o que está guardado nela. A janela, às vezes, ignora parte do que está lá dentro. Ter espaço não garante que o modelo use bem esse espaço. Por isso uso a expressão memória útil do agente de IA: a janela total é a memória disponível, e a memória útil é a parte que o modelo realmente consegue aproveitar.
O que é carregado dentro da janela de contexto
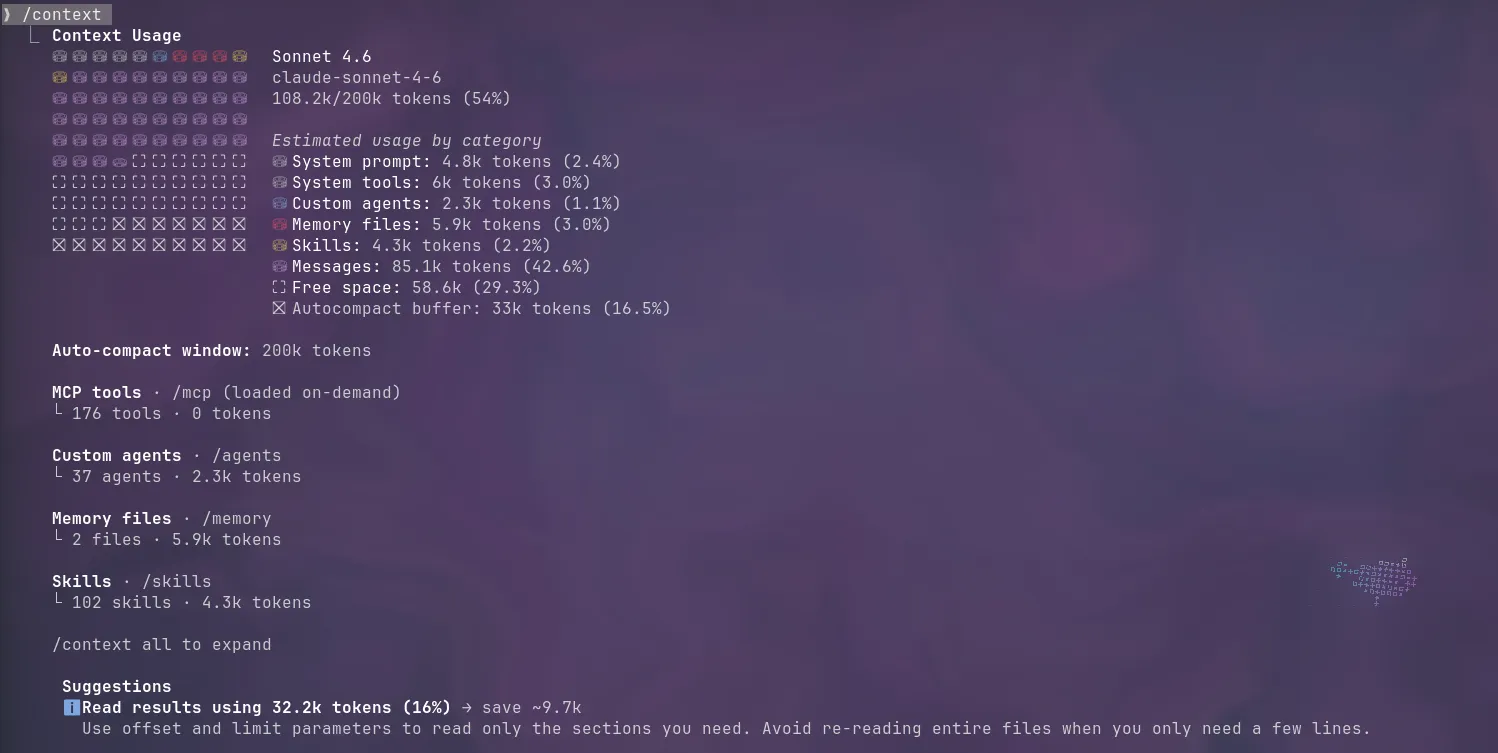
Tudo o que o modelo lê ou escreve numa interação conta para a janela: o prompt de sistema, as mensagens, as definições de ferramentas, os resultados de ferramentas, imagens e documentos. A resposta que está sendo gerada também conta, inclusive o raciocínio do modelo. OpenAI e Google dizem o mesmo.
Olhe a proporção: só cerca de 5% daquela janela era conversa. Boa parte do resto é o que o sistema carrega antes de você digitar qualquer coisa, e o espaço que sobra para você é sempre menor que a janela anunciada.
Qual a importância da janela de contexto
A janela de contexto define até onde o modelo consegue ir numa tarefa, com que qualidade e a que custo. Vejo quatro motivos para prestar atenção nela.
A primeira é a tarefa longa, sobretudo com agentes. Um agente trabalha em ciclos: a cada passo, chama uma ferramenta, recebe o resultado e responde. Cada passo se acumula na janela, então quanto mais longa a tarefa, mais rápido ela enche. Uma conversa curta raramente encosta no limite. Um agente que roda por horas pode encostar, e aí o problema deixa de ser só de espaço e passa a ser de como o espaço é usado.
A segunda é a qualidade. A própria documentação da Anthropic avisa que mais contexto não é automaticamente melhor. No teste da Chroma, um prompt focado de cerca de 300 tokens superou o mesmo pedido com cerca de 113 mil tokens, em todas as famílias de modelos testadas. Colocar tudo na janela parece seguro, mas pode piorar o resultado.
A terceira é o custo. Você paga por token, e cada mensagem reenvia o contexto inteiro. Na API da OpenAI, prompts acima de 272 mil tokens no GPT-6 custam o dobro na entrada. A Anthropic não cobra sobretaxa nos modelos atuais, e o cache de contexto muda a conta: o Manus relatou tokens em cache 10 vezes mais baratos.
E o português paga mais. Textos em português costumam virar mais tokens que o mesmo texto em inglês. A razão está no tokenizador, a peça que corta o texto em tokens antes de o modelo ler. Um estudo de maio de 2026, ainda sem revisão por pares, comparou seis tokenizadores atuais, entre eles o do GPT-4o, usando o mesmo conteúdo traduzido para mais de 20 línguas europeias. Em média, cada palavra em português virou 1,53 token, contra 1,23 no inglês: cerca de 24% a mais.
O inglês foi a língua mais barata em todos os modelos, e as línguas latinas, como o português, ficaram entre as mais eficientes. Mesmo assim, o mesmo pedido em português ocupa mais espaço na janela e custa mais. O estudo não testou Claude nem Gemini, então trate o número como estimativa.
Tudo isso leva a uma pergunta prática: quanto cabe em cada modelo?
Como sei o tamanho da janela de contexto?
A resposta mais confiável está na página de modelos de cada empresa. A tabela reúne cinco modelos de ponta, com o tamanho da janela na API.
Dados conferidos nas páginas oficiais em 9 de novembro de 2026.
Modelo | Empresa | Janela de contexto (API) | Saída máxima | Equivalência aproximada |
|---|---|---|---|---|
OpenAI | 1.050.000 tokens | 128 mil | ~790 mil palavras em inglês | |
Anthropic | 1.000.000 tokens | 128 mil | ~555 mil palavras (cálculo da Anthropic) | |
Anthropic | 1.000.000 tokens | 128 mil | ~555 mil palavras (cálculo da Anthropic) | |
1.048.576 tokens (entrada e saída somadas) | 65.536 (padrão) | ~8 romances (comparação do Google) | ||
DeepSeek | 1.000.000 tokens | 384 mil | ~750 mil palavras em inglês |
Em 2026, quase todos empataram em cerca de 1 milhão de tokens. A disputa agora está em quanto desse espaço o modelo usa bem, no limite de saída e no preço.
O que é token? Um pedaço de palavra. Em inglês, 100 tokens equivalem a cerca de 75 palavras, ou uns 4 caracteres por token, segundo a OpenAI. Mas o tokenizador muda de um modelo para outro. A Anthropic informa que, do Claude 4.7 em diante, o mesmo texto gera cerca de 30% mais tokens. Por isso, 1 milhão de tokens equivale a cerca de 555 mil palavras no Claude atual, e não 750 mil.
API e aplicativo não são a mesma coisa. A janela no aplicativo pode ser bem menor que na API. Na página de preços do ChatGPT, ela vai de 27 mil tokens, no plano gratuito e modo instantâneo, a 400 mil, no Pro e modo de raciocínio, contra 1,05 milhão na API. Nos planos pagos do Claude, os modelos mais novos aparecem com 1 milhão. No app do Gemini, o Argon está disponível só para assinantes AI Pro e Ultra. Confira sempre no plano que você usa, e não apenas no anúncio do modelo.
O que acontece quando a janela de contexto enche?
Quando a janela enche e você bate no limite de contexto, não existe um comportamento único. Depende do produto e de como você acessa o modelo.
No Claude pago, as mensagens mais antigas são resumidas automaticamente, e a conversa continua na maioria dos casos. Já no Claude Code, o sistema faz duas coisas em ordem: primeiro limpa saídas antigas de ferramentas, depois resume a conversa. A documentação avisa que instruções detalhadas do começo podem se perder nesse processo, e recomenda colocar regras permanentes no arquivo CLAUDE.md, que é relido a cada vez.
Na API da Anthropic, o caso é mais seco. Se a entrada sozinha passa do limite, a chamada falha com o erro "prompt is too long". Nos modelos mais novos, se entrada e saída somadas passam do limite, a resposta é cortada no meio, com um motivo de parada específico.
A API da OpenAI oferece compactação no servidor, e a API do Gemini reduz sozinha o limite de saída quando entrada e saída máxima passam de 1.048.576 tokens. No app do ChatGPT, a OpenAI não documenta oficialmente o que acontece no limite, então prefiro não afirmar como funciona.
O que é a degradação de contexto
A degradação de contexto, também chamada de apodrecimento de contexto ou deterioração de contexto, é a queda gradual de qualidade do modelo conforme a quantidade de texto na janela cresce, mesmo antes de ela encher. A janela cheia é um limite. A degradação é um declínio que começa bem antes.
Quando acontece a degradação de contexto
Sabe quando você pede algo lá no começo da conversa, a IA segue certinho, e uma hora ela parece ter esquecido? Muitas vezes, a informação nem saiu da janela. Ela está lá, mas o modelo deu menos atenção a ela. Imagine uma mesa coberta de papéis: quanto mais papel, mais fácil é deixar passar o que está no meio da pilha.
O significado de degradação de contexto (context rot)
O nome em inglês, context rot, nasceu quase de brincadeira. O registro mais antigo que encontrei é um comentário no Hacker News, de 18 de junho de 2025, em que um usuário sugeriu o nome.
Eu já vi alguns autores usarem "deterioração" de contexto, porém eu queria, e suplico que me escutem, propor usar o termo degradação, que é muito mais fácil de pronunciar em vídeos, palestras e conversas. Então deterioração de contexto é o mesmo que degradação de contexto.
A própria documentação da Anthropic, em inglês, explica o problema dizendo que a precisão do modelo se degrada conforme os tokens aumentam.
Principais pesquisas feitas sobre degradação de contexto
Em 14 de julho de 2025, a Chroma publicou o relatório "Context Rot", testando 18 modelos. A conclusão foi que os modelos não usam o contexto de forma uniforme, e que o desempenho cai com entradas maiores, mesmo em tarefas simples.
No Lost in the Middle, de Liu et al., de 2023, o modelo lembra melhor do começo e do fim do texto, e pior do meio, num padrão em U. Com 20 documentos e a resposta no meio, o GPT-3.5 acertou 53,8%. Sem nenhum documento, acertou 56,1%. Ter a informação no meio foi pior do que não ter nada.
No RULER, de 2024, só cerca de metade dos 17 modelos testados manteve bom desempenho em 32 mil tokens, embora todos anunciassem 32 mil ou mais. A janela anunciada é, portanto, maior que a janela efetiva.
No NoLiMa, de 2025, a pergunta não repete as palavras do trecho que contém a resposta. O GPT-4o caiu de 99,3% para 69,7% em 32 mil tokens. Nesse tamanho, onze dos treze modelos testados ficaram abaixo da metade do desempenho que tinham com textos curtos.
Já o estudo de Du et al. (2025) isolou um fator: o tamanho da entrada, sozinho, prejudica o desempenho, com quedas de 13,9% a 85%, mesmo quando a informação certa está lá.
Por que a degradação de contexto acontece?
Pelo que essas pesquisas indicam, a atenção do modelo se dilui entre muitos tokens. Textos irrelevantes e parecidos com a pergunta distraem, instruções antigas competem com as novas, e os modelos foram treinados com menos exemplos de textos muito longos.
Conclusão
A janela de contexto é a memória de trabalho do modelo. Em 2026, e provavelmente em 27, quase todos os modelos de ponta chegam a cerca de 1 milhão de tokens, mas o espaço que o modelo usa bem é menor que o anunciado. O jogo é usar bem a janela de contexto, com engenharia de contexto, e evitar a degradação de contexto, que começa antes de ela encher.
Lembre que janela cheia e degradação são problemas diferentes. Um é limite; o outro é queda de atenção.
Perguntas frequentes sobre janela de contexto
Qual IA tem a maior janela de contexto?
Entre os modelos de ponta de novembro de 2026, o GPT-6 Astra lidera por pouco, com 1,05 milhão de tokens na API. Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Argon e DeepSeek V4.1-Flash ficam em cerca de 1 milhão. Na prática, a diferença é pequena.
Quantas palavras cabem em 1 milhão de tokens?
Depende do tokenizador do modelo. Em inglês, a conta vai de cerca de 555 mil palavras no Claude atual, segundo cálculo da Anthropic, a cerca de 790 mil no GPT-6 Astra. Em português cabem menos, porque o mesmo texto costuma gerar mais tokens.
Janela de contexto é a mesma coisa que a memória do ChatGPT?
Não. A janela é o que o modelo lê agora, para gerar esta resposta. A memória do produto fica fora da janela, e algumas informações dela são trazidas para dentro, passando a ocupar espaço.
Uma janela de contexto maior é sempre melhor?
Não. Por causa da degradação de contexto, um contexto enxuto e relevante costuma dar respostas melhores que uma janela lotada. No teste da Chroma, um prompt focado de cerca de 300 tokens superou o mesmo pedido com cerca de 113 mil tokens.